
Alle Artikel
gVisor Tenant-Trennung via user-space Kernel in Kubernetes
Namespaces trennen Tenants nur in der Control Plane, zur Laufzeit teilen sie sich den Kernel. Wir zeigen, wie die gVisor Tenant-Trennung als zweite Grenze funktioniert, wie Sie sie einrichten und welchen Overhead sie kostet.
·
Dominik Heilbock

Warum Namespaces keine Tenant-Grenze sind
In einem multi-tenant Kubernetes-Cluster teilen sich alle Pods auf einem Node einen einzigen Linux-Kernel. Ein einziger Kernel-Exploit im Workload eines Tenants greift daher auf jeden anderen Tenant auf diesem Node über. Namespaces, RBAC und Quotas trennen Tenants in der Control Plane. Zur Laufzeit ist die einzige Mauer zwischen ihnen die Angriffsfläche des Host-Kernels. Mit der gVisor Tenant-Trennung erhält Kubernetes genau an dieser Stelle eine zweite Grenze.
Zum Beispiel zeigen NetworkPolicies das Problem deutlich. Sie werden durchgesetzt, indem iptables-Regeln und eBPF-Filter auf dem Host angewandt werden. Ein Angreifer, der aus einem Container auf den Host ausbricht, kann diese Regeln einfach umschreiben und jeden Pod eines anderen Tenants erreichen.
gVisor fügt eine zweite Grenze hinzu. Dadurch landet ein Workload, der aus seinem Prozess ausbricht, im User-Space-Kernel von gVisor und nicht auf dem Host. Von dort aus muss er noch eine Reihe von Komponenten überwinden, bevor sie den Node, den Network Stack des Hosts oder einen anderen Tenant berühren kann.
Die Idee hinter gVisor
gVisor ist eine in Go geschriebene User-Space-Neuimplementierung der Linux-Syscall-ABI. Die Syscalls eines Tenants werden vom Code von gVisor in einem separaten Prozess bedient und nicht vom Host-Kernel. Wenn gVisor den Host tatsächlich benötigt, baut es diese Calls aus seinem eigenen Zustand auf, statt sie weiterzuleiten. Dadurch gelangt nichts, was der Tenant übergeben hat, unverändert zum Host-Kernel. Für die Tenant-Isolation bedeutet das: Ein Tenant spricht nie direkt mit dem gemeinsam genutzten Kernel. Jeder Pod erhält seinen eigenen Userspace-Kernel, und der gemeinsame Kernel sieht von diesem nur eine kleine, feste Menge an Anfragen.
Drei Komponenten, keinem wird alles anvertraut
gVisor teilt seinen Kernel in separate Prozesse auf, sodass keiner von ihnen sowohl vom Angreifer kontrollierten Code ausführen als auch frei auf den Host zugreifen kann. Seit directfs 2023 zum Standard wurde, ist die Trennung zwischen Sentry und Gofer lockerer als zuvor. Mit --directfs=false wird die strikte Variante wiederhergestellt.
Der Stub führt den Code des Tenants aus, kann aber keinen einzigen Host-Syscall absetzen. Jeder Call wird in den Sentry abgefangen. Der Sentry ist der Kernel pro Pod. Er fängt jeden Syscall ab und implementiert ihn in Go neu, wodurch der Großteil memory safe ist. Seine eigenen Host-Syscalls durchlaufen einen strikten seccomp-Filter, der standardmäßig socket, exec und connect blockiert. Mit directfs darf er Dateien öffnen, jedoch nur relativ zu File Descriptors, die ihm der Gofer übergeben hat, mit O_NOFOLLOW und niemals in procfs; im gehärteten Modus sind auch Datei-Syscalls blockiert. Er läuft in eigenen User-, Mount- und PID-Namespaces, innerhalb von cgroups und eines pivot_root. Der Gofer läuft außerhalb der Sandbox und richtet den Dateizugriff ein. Er baut die Mounts des Containers in seinem eigenen Mount-Namespace und pivot_root auf und übergibt dem Sentry anschließend für jeden Mount-point einen File Descriptor.
Ein open() durch die Sandbox verfolgt
Der File Descriptor eines Tenants existiert unter gVisor nirgends auf dem Host. Nehmen wir diesen Call:
Der Call wird abgefangen, bevor er zu einem gewöhnlichen Host-Syscall wird.
Der Sentry löst den Pfad anhand seiner eigenen Sicht auf das Dateisystem des Containers auf. Berechtigungen, Symlinks und das Durchlaufen von Mounts übernimmt er selbst.
Er ruft
openatselbst auf dem Host auf, und zwar relativ zu einem File Descriptor des Mounts, den der Gofer beim Start der Sandbox übergeben hat. Sein seccomp-Filter erlaubt dies nur mitO_NOFOLLOWund niemals in procfs, sodass weder..noch ein untergeschobener Symlink aus dem Dateisystem des Containers hinausführt.Der Host liefert fd 15 in die eigene File-Descriptor-Tabelle des Sentry zurück.
Der Sentry legt den Anwendungs-fd 3 in seiner internen Tabelle an und gibt ihn zurück.
Im gehärteten Modus (--directfs=false) wird Schritt 3 zu einem RPC an den Gofer. Der Gofer öffnet die Datei und gibt den File Descriptor zurück, und der Sentry benötigt überhaupt keine Datei-Syscalls.
Unter runc wäre fd 3 ein echter Eintrag in der File-Descriptor-Tabelle des Hosts, sichtbar in /proc/<pid>/fd. Unter gVisor gibt es zwei Tabellen. Der fd 3 des Tenants ist ein Index in eine Go-Datenstruktur innerhalb des Sentry; der Host kennt nur den fd 15 des Sentry.
Netstack: ein privater Network Stack pro Tenant
gVisor betreibt innerhalb des Sentry einen eigenen Network Stack, Netstack. Daher berühren der TCP-Zustand, Steuernachrichten und der Paketaufbau eines Tenants nie den Network Stack des Hosts. Nur fertige Frames des Link Layers verlassen die Sandbox. Sie werden auf das virtuelle Gerät im Network-Namespace des Pods geschrieben, das Docker oder Kubernetes eingerichtet hat.
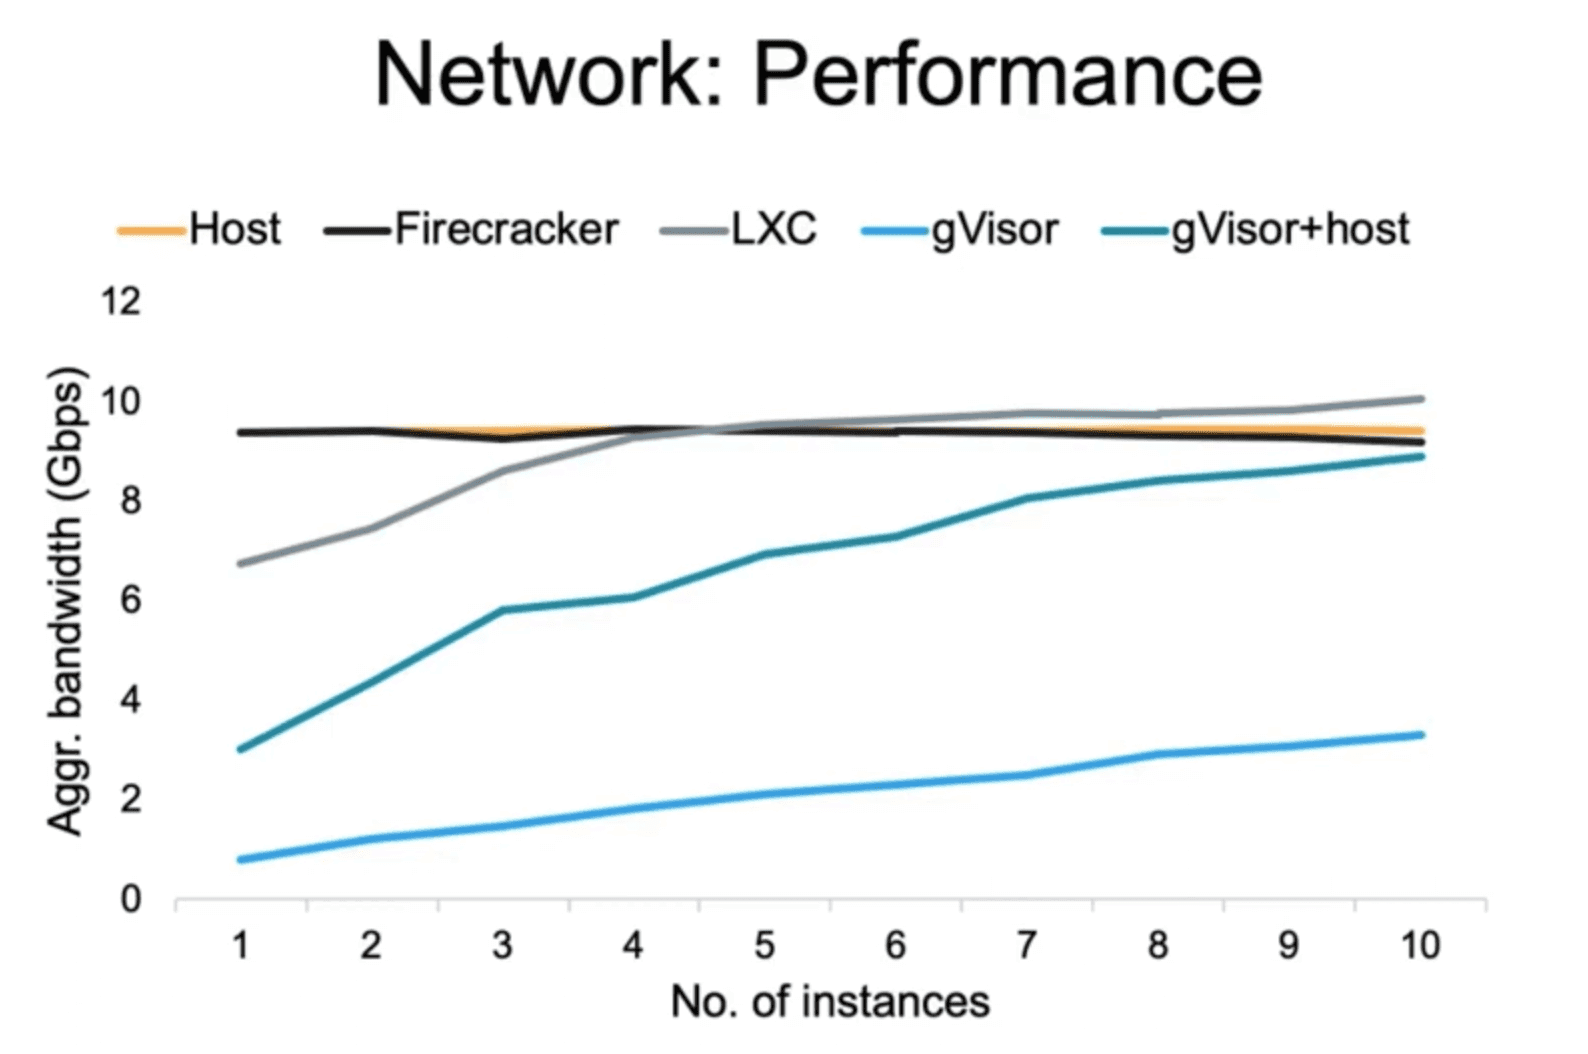
Quelle: Anjali, T. Caraza-Harter, M. M. Swift, Blending Containers and Virtual Machines: A Study of Firecracker and gVisor, VEE 2020.
Das ist für das NetworkPolicy-Problem aus der Einleitung relevant. Ein Tenant, der seinen Workload kompromittiert, landet im Sentry, der keine Möglichkeit hat, die iptables-Regeln oder eBPF-Programme des Hosts zu erreichen. Die Richtlinien werden weiterhin auf der Host-Seite durchgesetzt, außerhalb der Reichweite des Angreifers. Es gibt jedoch zwei Einschränkungen.
Zum einen lässt sich Netstack zugunsten von Host-Networking abschalten, um einen höheren Throughput zu erzielen. Damit wird die Paketverarbeitung des Tenants wieder dem Host-Kernel übergeben, und der Großteil dieser Isolation geht verloren. Zum anderen entfernt Netstack den Netzwerkcode des Hosts nicht aus dem Pfad. Messungen der Codeabdeckung zeigen, dass gVisor weiterhin erhebliche Teile des Linux-Netzwerkcodes nutzt, sodass Fehler dort erreichbar bleiben (Vortrag).
Die Isolation durch Netstack hat jedoch messbare Throughput-Kosten. In iperf3-Messungen von Anjali et al. erreichte gVisor mit Netstack über 1 bis 10 Instanzen hinweg aggregiert etwa 1 bis 3 Gbit/s, während der Host, Firecracker und LXC bei etwa 9 bis 10 Gbit/s lagen. Die Umstellung von gVisor auf Host-Networking schloss dagegen den Großteil dieser Lücke.
Diese Zahlen stammen aus der Zeit vor mehreren Jahren an Netstack-Optimierungen.
Plattformen: Systrap und KVM
gVisor benötigt eine Möglichkeit, die Syscalls und Page Faults eines Tenants abzufangen. Diese Mechanismen nennt es Plattformen.
Plattform | Art des Abfangens | Erfordert Hardware-Virtualisierung |
|---|---|---|
Systrap (Standard) | seccomp-bpf, als Trap statt als Filter eingesetzt | Nein |
KVM | Linux KVM | Ja |
Was ein Angreifer nach einem Ausbruch erhält
Ein Tenant, der den Sentry vollständig kompromittiert, gewinnt kaum mehr, als er ohnehin schon hatte. Mit directfs hält er Host-File-Descriptors für die Mounts des eigenen Pods und einen seccomp-Filter, der ihm das Öffnen von Dateien nur unterhalb davon erlaubt, ohne Symlinks zu folgen oder procfs zu betreten. Im gehärteten Modus ist er weiter eingeschränkt, nämlich auf das, was die RPC-Schnittstelle zwischen Sentry und Gofer zulässt.
Folglich gehörte alles, was darüber erreichbar ist, bereits dem Tenant. Was ein echter Ausbruch benötigt, fehlt schlicht: /proc/sys, Host-Einträge unter /proc, /dev/kvm, der Socket der Container-Runtime, die Volumes anderer Tenants. Ein hostPath-Volume liegt per Definition in der Sicht des Gofer. Wird etwas Sensibles in den Pod eines Tenants gemountet, erhält ein kompromittierter Sentry es ebenfalls. In einem multi-tenant Cluster sollte hostPath für Tenant-Namespaces grundsätzlich untersagt werden.
gVisor Tenant-Trennung in Kubernetes einrichten
Kubernetes wählt gVisor pro Pod über eine RuntimeClass aus, sodass sich nicht vertrauenswürdige Tenants in einer Sandbox betreiben lassen, während vertrauenswürdige System-Workloads auf runc bleiben. Die Runtime-Binärdatei von gVisor heißt runsc, und containerd spricht sie wie jede andere Runtime über einen Shim an.
Registrieren Sie die Runtime auf jedem Sandbox-Node bei containerd:
Machen Sie diese im Cluster verfügbar:
Wählen Sie diese anschließend in den Pods des Tenants aus:
Ein Feld in einer Pod-Spezifikation ist eine Anforderung, keine Grenze. Für eine echte Tenant-Trennung sollten Sie dies über Admission-Richtlinien erzwingen.
Der Preis: Overhead nach Workload-Typ
Wie stark gVisor einen Workload verlangsamt, hängt davon ab, wie oft er in den Kernel wechselt. CPU-lastige Arbeit zahlt fast nichts, reine I/O-Arbeit zahlt am meisten, und die meisten typischen Anwendungen liegen dazwischen.
Workload | Overhead | Grund |
|---|---|---|
CPU-lastig | Nahe null | Geringe Kernel-Beteiligung auf dem Hot Path |
Speicher | Langsame Allokation, native Geschwindigkeit bei der Nutzung | Die Allokation läuft über den Sentry, der Zugriff nicht |
Netzwerk | Der höchste | Netstack, der Go-basierte Network Stack im User-Space |
Festplatte, metadatenlastig | Moderat, hoch mit | Jeder Lookup ist ein abgefangener Syscall. Im gehärteten Modus zusätzlich ein Roundtrip zum Gofer |
Festplatte, Throughput | Geringer | Lese- und Schreibzugriffe gehen direkt an den Host-File-Descriptor |
Allerdings stammen viele veröffentlichte Benchmarks aus der Zeit vor directfs, das dem Sentry direkten Zugriff auf File Descriptors gibt und die meisten Gofer-Roundtrips entfernt. Führen Sie daher Benchmarks mit einem aktuellen Release durch, bevor Sie gVisor für I/O-intensive Tenants ausschließen.
Fazit
gVisor macht aus dem gemeinsam genutzten Node-Kernel, der für Tenants eine direkte Angriffsfläche ist, etwas, das nur über eine kleine, feste Menge an Calls eines memory safen, stark eingeschränkten Prozesses erreichbar ist. Für Cluster, die Code von Tenants ausführen, die einander nicht vertrauen, ist das eine echte zweite Grenze, und zwar zu Kosten, die die meisten Anwendungen verkraften.
gVisor funktioniert jedoch nur als Teil einer Richtlinie, nicht als Schalter:
Erzwingen Sie
runtimeClassName: gvisorfür jeden Tenant-Namespace über Admission Controls.Untersagen Sie Tenants hostPath, hostNetwork und privilegierte Pods.
Lassen Sie Netstack für Tenants aktiviert, es sei denn, der Netzwerk-Throughput wiegt die Isolation eindeutig auf.
Behalten Sie NetworkPolicies bei. gVisor hält sie außerhalb der Reichweite eines Tenants, ersetzt sie aber nicht.
Falls Sie sich für das Sandboxing von KI-Agenten mit lightweight VMs interessieren: Mein Kollege Jannis hat genau dazu einen Artikel geschrieben: liquidreply.net/blog/ai-agent-sandbox-amazon-eks-kata-containers
Quellen
Optimizing gVisor filesystems with Directfs, gVisor-Blog, 2023
Anjali, Tyler Caraza-Harter, Michael M. Swift (Authors Info & Claims), Blending Containers and Virtual Machines: A Study of Firecracker and gVisor, VEE '20: Proceedings of the 16th ACM SIGPLAN/SIGOPS International Conference on Virtual Execution Environments, Seiten 101–113, 2020, doi.org/10.1145/3381052.3381315 (Vortrag)
Nehmen Sie Kontakt mit uns auf, wenn Sie Tenant-Trennung für Ihre Workload-Plattform aufbauen möchten: liquidreply.net/contact
Teilen