
Alle Artikel
LLMOps-Observability: Infrastruktur, Runtime, Analytik
LLMOps-Observability reicht weit über die Überwachung von Modell-Endpoints hinaus. Dieser Artikel untersucht zentrale Fähigkeiten auf drei verbundenen Ebenen - Infrastruktur, Runtime und analytische Observability - und erklärt, wie sie Engineering-Teams dabei helfen, die Plattformgesundheit zu beurteilen, einzelne Anfragen zu untersuchen und festzustellen, ob sich ein LLM-System im Zeitverlauf verbessert.
·
Lino Deppe

Observability jenseits des klassischen Monitorings
Frühere Artikel haben die Hardware-Entscheidungen untersucht, die eine KI-Strategie prägen, sowie die Deployment-Entscheidungen beim Betrieb von LLMs in Produktion. Sobald ein solches System läuft, müssen Teams zwei Dinge wissen: ob es funktioniert und warum es sich so verhält, wie es sich verhält. Der übliche Ausgangspunkt ist klassisches Monitoring, das vordefinierte Fragen beantwortet: Ist der Endpoint verfügbar? Liegt die Latenz innerhalb des Service-Level-Objectives? Hat die Fehlerrate einen Alarmschwellenwert überschritten? LLMOps-Observability geht weiter und verbindet Infrastruktur-, Runtime- und Analysedaten.
Diese Signale bleiben unverzichtbar, können aber nicht vollständig erklären, ob eine Antwort auf dem abgerufenen Kontext basierte, warum ein Agent in eine kostspielige Tool-Schleife geraten ist oder ob eine Modelländerung die Task-Completion verringert hat.
Monitoring überwacht bekannte Zustände anhand vordefinierter Metriken, Dashboards und Alerts. Observability liefert die Evidenz, die nötig ist, um unerwartetes Verhalten zu untersuchen, indem Metriken, Logs, Traces, Evaluationen, Konfigurationen und Ergebnisse miteinander korreliert werden.
Tracing ist ein Teil dieser Evidenz: Es rekonstruiert den Weg einer Anfrage über Modellaufrufe, Retrieval, Tools, Guardrails, Retries und weitere Komponenten hinweg. Die Evaluation bewertet Eigenschaften wie Groundedness, Relevanz, Sicherheit oder Task-Erfolg, entweder für eine einzelne Antwort oder über einen größeren Datensatz hinweg. Weder Tracing noch Evaluation allein stellen Observability dar; ihr Wert entsteht dadurch, dass sie mit operativer Telemetrie, Konfiguration und Ergebnissen verknüpft sind.
In diesem Artikel bezeichnet LLMOps-Observability diesen breiteren operativen Umfang. Er erweitert die LLM-Observability um die Infrastruktur und die analytischen Praktiken, die erforderlich sind, um LLM-Systeme in Produktion zu betreiben und zu verbessern. Diese Evidenz umfasst drei einander ergänzende Ebenen:
Infrastruktur-Observability: Ist die Plattform gesund und kosteneffizient?
Runtime-Observability: Was ist während dieser Anfrage geschehen?
Analytische Observability: Verbessert oder verschlechtert sich das System im Zeitverlauf?
Diese Ebenen sind keine voneinander isolierten Technologie-Tiers. Sie arbeiten mit unterschiedlicher Granularität und auf unterschiedlichen Zeitskalen und bilden einen Pfad von der Infrastruktur unterhalb des Systems über die Ausführung laufender Anfragen bis hin zur analytischen Evidenz, die künftige Verbesserungen leitet.
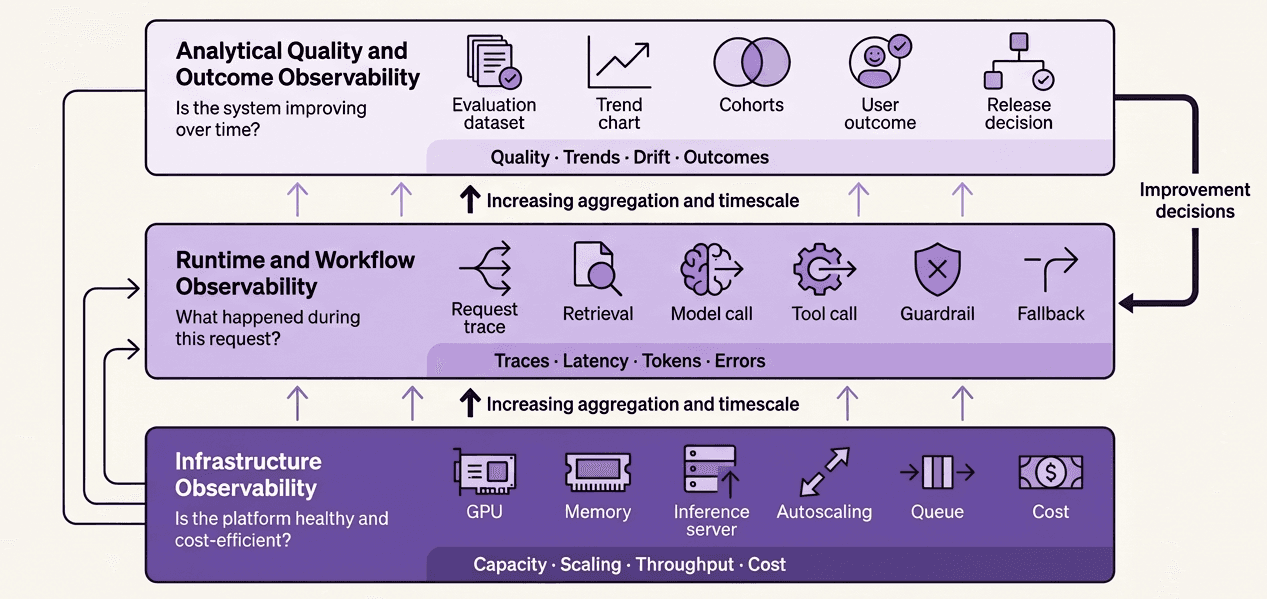
Abbildung 1: Die drei miteinander verbundenen Ebenen der LLMOps-Observability
Ebene 1: Infrastruktur-Observability
Die Infrastrukturebene fragt: Kann die Plattform die Workload zuverlässig, effizient und zu akzeptablen Kosten bedienen?
Beim selbst gehosteten Inference gehören zu den relevanten Signalen die GPU-Auslastung und -Sättigung, die Nutzung von GPU-Speicher und Key-Value-Cache, der Durchsatz an Anfragen und Tokens, die Queue-Tiefe, die Prefill- und Decode-Performance sowie die Batching-Effizienz. Autoscaling-Verhalten und Cold-Start-Latenz zeigen, ob die Kapazität der Nachfrage folgen kann, ohne untragbare Verzögerungen oder unnötige Kosten zu verursachen.
Hardware-Telemetrie kann Probleme aufdecken, die Metriken auf Anwendungsebene nicht erklären können. Temperatur, Leistungsgrenzen, thermisches Throttling, ECC-Fehler (Error-Correcting Code) und Fehler auf Geräteebene können sich allesamt auf Performance oder Verfügbarkeit des Servings auswirken.
Die durchschnittliche GPU-Auslastung sollte nicht isoliert interpretiert werden. Eine niedrige Auslastung kann auf Überprovisionierung hindeuten, aber auch auf unzureichendes Batching, langsames Retrieval, CPU-Engpässe oder stoßweise Nachfrage zurückgehen. Eine hohe Auslastung mag akzeptabel sein, bis sie zu wachsenden Queues führt oder ein Time-to-First-Token-Ziel (TTFT) verletzt.
Die sinnvolle Analyseeinheit ist eine korrelierte Menge von Signalen. So deutet beispielsweise eine steigende Queue-Tiefe bei gleichbleibendem Request-Durchsatz und gesättigtem GPU-Speicher auf eine andere Einschränkung hin als eine niedrige GPU-Auslastung in Kombination mit langsamem vorgelagertem Retrieval.
Auch die Kostenzuordnung gehört zu dieser Ebene. GPU-Stunden und Infrastrukturkosten sollten sich Workloads, Modellen, Teams oder Produkten zuordnen lassen, statt als undifferenzierte Plattformrechnung bestehen zu bleiben.
Platform Engineering und Site Reliability Engineering verantworten diesen Bereich in der Regel gemeinsam mit den Model-Serving-Teams. GPU-Exporter, Metriken der Inference-Server, Dashboards von Orchestrator und Cloud, Kostensysteme und Ressourcen-Metadaten liefern die Rohtelemetrie, die entscheidende Fähigkeit ist jedoch die Korrelation zwischen Hardwarezuständen, Serving-Verhalten und Workload-Identität.
Bei verwalteten Modell-APIs verbleibt ein Großteil dieser Infrastruktur-Telemetrie beim Anbieter, sodass sich der Fokus des Kunden auf Quotas, Rate Limits, regionale Verfügbarkeit, Latenz und Kosten verlagert.
Beispiele für Infrastruktur-Tooling
Die folgenden Beispiele sind repräsentativ und stellen keinen vorgegebenen Stack dar. Die erforderlichen Fähigkeiten sollten definiert werden, bevor konkrete Produkte ausgewählt werden.
Tool oder Standard | Relevante Fähigkeit |
NVIDIA DCGM Exporter und Prometheus | Erfassen Telemetrie zu GPU-Auslastung, Speicher, Leistungsaufnahme, Temperatur und Hardware-Zustand. |
Triton, vLLM oder gleichwertige Serving-Tools | Stellen Metriken zu Durchsatz, Queue-Latenz, Cache-Auslastung und Batching-Effizienz bereit. |
Kubernetes- und Cloud-GPU-Dashboards | Bieten Einblick in Workload-Zustand, Autoscaling, Kapazität und Infrastrukturkosten. |
OpenTelemetry-Ressourcen-Metadaten | Korrelieren Serving-Workloads mit den Infrastrukturressourcen, auf denen sie laufen. |
Ebene 2: Runtime- und Workflow-Observability
Die Runtime-Ebene fragt: Was ist während dieser Anfrage geschehen, und warum?
Eine LLM-Anwendung sollte als verteilter Workflow und nicht als einzelner Modell-API-Aufruf beobachtet werden. Eine einzige Nutzeranfrage kann Prompt-Zusammenstellung, Retrieval, Reranking, mehrere Modellaufrufe, Tool-Ausführung, Guardrails, Retries, Fallbacks und Antwortverarbeitung umfassen. Eine erfolgreiche HTTP-Antwort zeigt nicht, welche Stufe die Latenz dominiert, das Token-Budget verbraucht oder ein ungeeignetes Ergebnis erzeugt hat.
Verteilte Traces sollten daher den vollständigen Ausführungspfad abbilden. Zu den relevanten Signalen gehören End-to-End-Latenz, Fehlerrate, TTFT, Inter-Token-Latenz oder Output-Token-Durchsatz, Anzahl der Input- und Output-Tokens, Stop-Gründe, Truncation, Timeouts, Rate Limits, Abbrüche, Retries sowie Kosten pro Anfrage oder Workflow.
Das Retrieval bringt zusätzliche Signale mit sich, etwa Latenz, Anzahl der Ergebnisse, Rate ergebnisloser Abfragen und Reranking-Verhalten. Agentische Workflows erfordern Transparenz über Latenz und Erfolg von Tool-Aufrufen, wiederholte Schritte, Amplification, Abbruchgründe, Guardrail-Entscheidungen und die Aktivierung von Fallbacks.
Ein Trace benötigt außerdem genügend Konfigurationskontext, damit die Ausführung diagnostizierbar und über Releases hinweg vergleichbar ist. Dazu gehören Modell und Anbieter, Prompt- oder Agent-Version, Version des Retrieval-Index, Deployment-Version, relevante Inference-Einstellungen, Tool-Aufrufe, Retries und Fallbacks. Ohne diesen Kontext zeigt ein Trace womöglich, wo Zeit verbracht wurde, erklärt aber nicht, warum sich das Verhalten zwischen Releases geändert hat.
Nicht jede Evaluation gehört in den synchronen Anfragepfad. Deterministische Schema- oder Formatvalidierung kann oft inline laufen, während sicherheitskritische Guardrails eine Antwort unter Umständen blockieren müssen, bevor sie den Nutzer erreicht. Aufwendigere modellbasierte Evaluationen werden meist besser asynchron auf einer Stichprobe des Traffics ausgeführt, mit stärkerem Sampling bei Fehlern, Anomalien, negativem Feedback und neuen Deployments.
Runtime-Observability unterstützt unmittelbare operative Entscheidungen: alarmieren, erneut versuchen, einen Fallback auf einen anderen Anbieter oder ein anderes Modell aktivieren, einen Circuit Breaker öffnen, eine eingeschränkte Antwort zurückgeben oder an einen Menschen eskalieren. Ihre Hauptnutzer sind Anwendungsteams, Platform Engineers, SREs und Engineers mit On-Call-Verantwortung.
Das Telemetrie-Design muss zudem Datenschutz und Kardinalität berücksichtigen. Prompts und Antworten können personenbezogene, vertrauliche oder regulierte Informationen enthalten, weshalb Produktivsysteme gezielte Redaktion, Zugriffskontrollen, Aufbewahrungsrichtlinien und Sampling benötigen. Identifikatoren mit hoher Kardinalität wie Request-, Conversation- und User-IDs gehören in Traces und nicht in Metrik-Labels.
Beispiele für Runtime-Tooling
Diese Beispiele veranschaulichen unterschiedliche Ansätze für Instrumentierung, Workflow-Tracing, Debugging und Telemetrie-Korrelation. Einige Produkte decken mehr als eine Observability-Ebene ab.
Tool oder Standard | Relevante Fähigkeit |
OpenTelemetry GenAI Conventions | Bieten herstellerneutrale Instrumentierung und gemeinsamen Kontext für Traces von LLM-Workflows. |
LangSmith | Unterstützt die Inspektion von LLM-Chains, Agents, Modellaufrufen und Tools auf Trace-Ebene. |
Arize Phoenix | Bietet Open-Source-Tracing, Evaluation und Debugging für LLM-Anwendungen. |
Datadog LLM Observability | Korreliert LLM-Workflows mit Anwendungs- und Infrastruktur-Telemetrie. |
Ebene 3: Analytische Observability für Qualität und Ergebnisse
Die analytische Ebene fragt: Verbessern oder verschlechtern sich Qualität, Sicherheit, Kosteneffizienz und Wirkung des Systems im Zeitverlauf?
Diese Ebene kombiniert Stichproben von Produktions-Traces, kontrollierte Evaluationsdatensätze, Nutzerfeedback und Produktmetriken. Ihre Analyseeinheit ist ein Datensatz, eine Kohorte, ein Release oder ein Zeitraum und nicht eine einzelne Anfrage.
Zu den gängigen Techniken gehören Golden-Set-Regressionstests, die nach einer Änderung eine kuratierte Menge repräsentativer Eingaben und erwarteter Verhaltensweisen erneut ausführen, um Qualitätsregressionen zu erkennen, sowie Human Review und Vergleiche von Modellen oder Prompts. Teams können außerdem Groundedness-Scoring (ob Antworten durch das verfügbare Quellmaterial gestützt werden) und Relevanz-Scoring einsetzen. Canary- und Shadow-Evaluationen helfen dabei, Änderungen vor einem vollständigen Release zu bewerten. Automatisierte Evaluationen können zudem eine Kalibrierung des Judge erfordern, damit die LLM-basierte Bewertung zuverlässig bleibt und mit menschlichen Einschätzungen übereinstimmt.
Produktionsergebnisse lassen sich nach Task, Tenant, Sprache, Dokumentkategorie, Modellversion oder Retrieval-Strategie segmentieren. Korrekturraten, Regenerierungen, Task-Completion, Eskalationen an Menschen und Kosten pro erfolgreich erledigtem Task verbinden technische Messwerte mit Nutzer- und Produktergebnissen.
Drift-Erkennung gehört hierher, doch Drift ist ein Untersuchungssignal und kein automatischer Fehler. Eine Veränderung der Eingabedaten, der Konzepte oder der Verteilung der Ausgaben wird operativ bedeutsam, wenn sie mit sinkender Qualität, Sicherheit, Kosteneffizienz oder schlechteren Nutzerergebnissen korreliert.
Auch Evaluationsergebnisse müssen versioniert werden. Jedes Ergebnis sollte das evaluierte Modell und den Prompt, den Datensatz oder die Produktionsstichprobe, das Judge-Modell und den Judge-Prompt, die Rubrik, den Retrieval-Index, Tool- und Token-Budgets sowie relevante Retry- und Inference-Einstellungen ausweisen. Andernfalls könnte eine scheinbare Verbesserung darauf beruhen, dass der Evaluator geändert wurde, und nicht darauf, dass die Anwendung besser geworden ist. Modellbasierte Judges sollten daher anhand menschlicher Bewertungen kalibriert werden, statt sie als unanfechtbare Ground Truth zu behandeln.
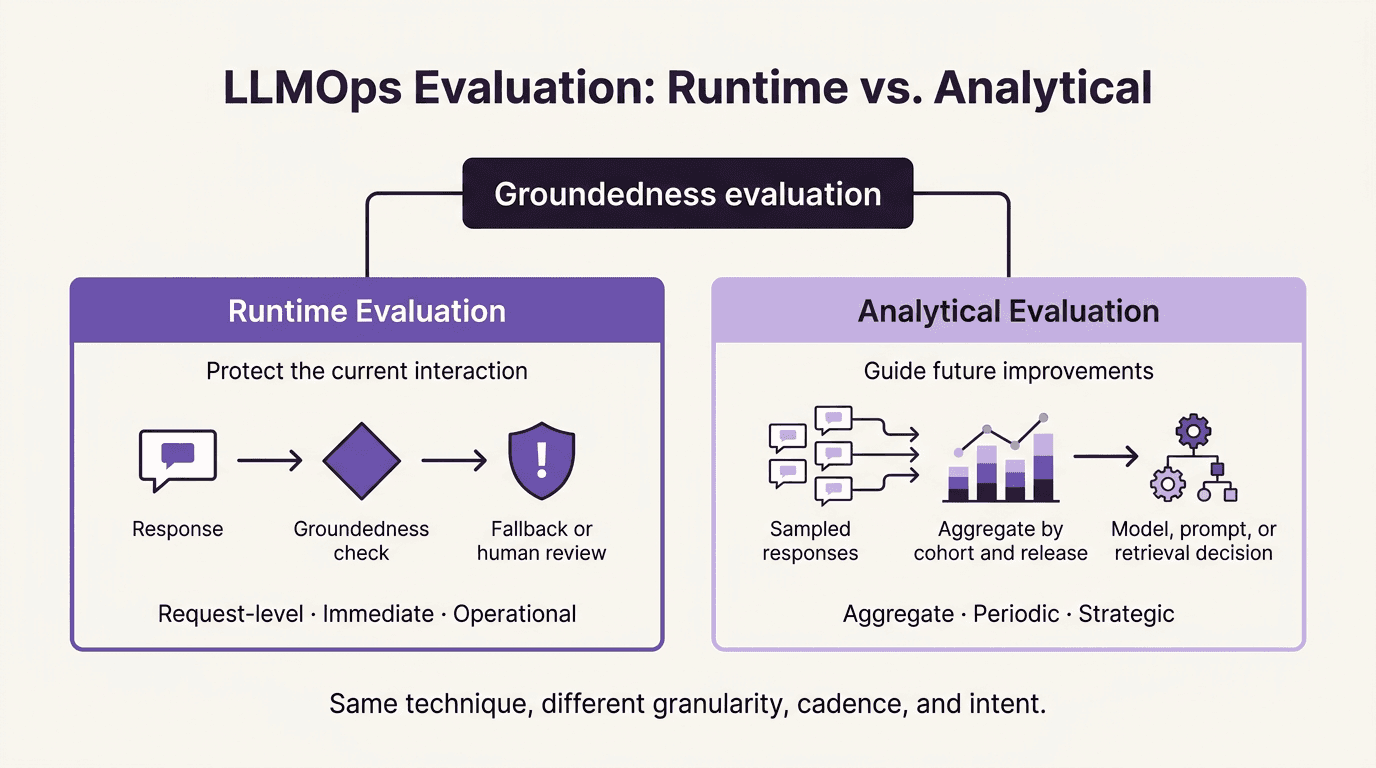
Abbildung 2: Groundedness-Evaluation: Runtime vs. analytisch
Runtime- und analytische Evaluation können dieselbe Technik verwenden, unterstützen aber unterschiedliche Entscheidungen. Eine Groundedness-Prüfung auf Anfrageebene kann einen Fallback oder ein Human Review auslösen, während aggregierte Groundedness-Scores Regressionen über Releases, Prompts, Modelle oder Dokumentkategorien hinweg aufzeigen können.
Der Unterschied liegt in Granularität, Taktung und Zielsetzung. Die Runtime-Evaluation erfolgt auf Anfrageebene und unmittelbar, mit dem Ziel, Nutzer und Servicezuverlässigkeit zu schützen. Die analytische Evaluation ist aggregiert und periodisch, mit dem Ziel, Modellauswahl, Prompt-Überarbeitungen, Retrieval-Verbesserungen, Guardrail-Änderungen und Release-Entscheidungen zu steuern.
Die Verantwortung erweitert sich folglich auf Tech Leads, ML Engineers, Architekten, Product Owner und Governance-Stakeholder.
Beispiele für analytisches Tooling
Diese Beispiele decken Evaluation, Drift-Analyse, Produktionsmonitoring und domänenspezifisches Benchmarking ab. Sie sollten anhand der erforderlichen Evaluationsmethoden, Governance-Kontrollen, des Integrationsmodells und der Deployment-Randbedingungen bewertet werden.
Tool oder Plattform | Relevante Fähigkeit |
Evidently | Erstellt Evaluationsberichte und unterstützt die Analyse von Daten- und Modell-Drift. |
Arize | Unterstützt Produktionsmonitoring und Performance-Analysen auf Kohortenebene. |
WhyLabs | Bietet Data Profiling, Drift-Erkennung und Monitoring der Modell-Performance. |
Eigene Evaluations-Pipelines | Setzen domänenspezifische Benchmarks, Qualitätsmetriken, Release Gates und Governance-Kontrollen um. |
Umsetzungsperspektive: Wo Kubernetes ins Spiel kommt
Die drei Ebenen definieren, was Teams beobachten müssen, nicht die Plattform, auf der Observability umgesetzt werden muss. Kubernetes ist weder eine Voraussetzung noch selbst eine Observability-Lösung, kann aber dort, wo es bereits im Einsatz ist, ein konsistentes operatives Fundament bieten.
Auf der Infrastrukturebene können Kubernetes-Metadaten wie Namespaces, Labels, Annotations und Service Accounts Workloads eine stabile Identität geben. Werden diese Metadaten als Resource Attributes in die Telemetrie aufgenommen, lassen sich GPU-Verbrauch, Serving-Verhalten, Kosten und Zuverlässigkeitssignale leichter bestimmten Modellen, Teams, Umgebungen und Releases zuordnen. Device Plugins ermöglichen es Kubernetes, GPUs als schedulbare Ressourcen zu behandeln, während Autoscaler auf Inference-bezogene Signale reagieren können. Die Skalierung bleibt dennoch durch Faktoren wie Provisionierung, Laden der Modelle und Datenbewegung begrenzt.
Auf der Runtime-Ebene können OpenTelemetry Collectors eine gemeinsame Pipeline bereitstellen, um Telemetrie aus unterschiedlichen Workloads anzureichern, zu filtern und zu exportieren. Anwendungen benötigen weiterhin eine gezielte Instrumentierung für Modellaufrufe, Retrieval, Tools, Retries und Evaluationen. Versionskontrollierte Deployments machen Releases zudem identifizierbar, sodass Teams Verhaltensänderungen bestimmten Änderungen an Anwendung, Konfiguration oder Model Serving zuordnen und diese bei Bedarf zurückrollen können.
Kubernetes-Kontrollen können auch die Telemetrie-Governance unterstützen. Role-Based Access Control (RBAC) beschränkt, wer auf Ressourcen zugreifen darf, während Network Policies, Secret-Management, Namespaces und Resource Quotas helfen, sensible Telemetrie zu isolieren und zu verhindern, dass Evaluations-Workloads mit dem produktiven Inference um Kapazität konkurrieren.
Für die analytische Observability können Kubernetes Jobs und zeitgesteuerte CronJobs Regressionstests und wiederkehrende Evaluationen ausführen. In CI/CD-Pipelines eingebunden, können ihre Ergebnisse Release Gates unterstützen, doch Kubernetes definiert weder die Datensätze noch die Bewertungskriterien oder Akzeptanzschwellen.
Plattformteams können diese Fähigkeiten als Self-Service-Abstraktionen bereitstellen, sodass Anwendungs- und ML-Teams standardmäßig konsistente Instrumentierung, Zugriffskontrollen und Evaluations-Workflows erhalten.
Von der Entscheidung her bauen, nicht vom Tool
Kubernetes zeigt, wie eine Plattform die drei Observability-Ebenen unterstützen kann, doch die Plattform sollte sich aus den operativen Entscheidungen ergeben, die Teams treffen müssen, und diese nicht vorgeben. Teams benötigen außerdem nicht von Anfang an auf allen drei Ebenen denselben Reifegrad. Sie sollten mit den Entscheidungen beginnen, die ihr Observability-System unterstützen muss:
Kann das Plattformteam Probleme bei Kapazität, Skalierung und Kosten diagnostizieren?
Kann ein On-Call-Engineer einen fehlgeschlagenen Workflow rekonstruieren?
Kann die technische Führung feststellen, ob ein Release Qualität und Nutzerergebnisse verbessert hat?
Das Ziel sind nicht drei unverbundene Dashboards, sondern eine korrelierte Evidenzkette, die Infrastrukturzustände, Anfrageausführung, Modellverhalten und Produktergebnisse miteinander verbindet. Diese Verbindung erlaubt es, eine Latenzregression, einen Kostenanstieg oder einen Qualitätsrückgang als Teil desselben Systems zu untersuchen statt in getrennten operativen Silos.
Bauen Sie Ihre Observability-Architektur um die Entscheidungen herum auf, die Ihre Teams treffen müssen, und nicht um die am Markt verfügbaren Tools. Definieren Sie zuerst die Fragen, Verantwortlichen, Zeitskalen und operativen Reaktionen und wählen Sie anschließend die Technologien aus, die diese am besten unterstützen.
Benötigen Sie Unterstützung beim Aufbau Ihrer LLMOps-Observability-Plattform?
Bei Liquid Reply unterstützen wir Engineering-Teams beim Entwurf und bei der Implementierung produktionsreifer Plattformen für LLM-Workloads. Dank unserer Expertise in Platform Engineering, Kubernetes und Cloud-Native-Infrastruktur können wir Infrastruktur-Telemetrie, Workflow-Tracing, kontinuierliche Evaluation, Governance und Kostentransparenz zu einer kohärenten LLMOps-Plattform verbinden.
Ob Sie Beratung zu Ihrer Observability-Strategie benötigen, Unterstützung bei der Integration dieser Fähigkeiten in eine bestehende Plattform oder eine End-to-End-Implementierung mit Self-Service-Abstraktionen für Anwendungs- und ML-Teams: Wir helfen Ihnen, von isolierten Signalen zu einem Betriebsmodell zu gelangen, das sowohl die tägliche Zuverlässigkeit als auch die langfristige Verbesserung unterstützt.
Kontaktieren Sie Liquid Reply für ein unverbindliches Erstgespräch.
Teilen