
Alle Artikel
Was ist eine Software Factory?
Wir definieren, was eine Software Factory ist: Agents führen Arbeit rund um die Uhr vom Signal bis zum Release, Menschen legen die Intention fest und geben die Ergebnisse frei.
·
Max Körbächer

Software Factory: Softwareproduktion, die rund um die Uhr läuft.
Software wurde schon immer von Hand gefertigt, selbst mit modernen Pipelines. Jemand las das Ticket, schrieb die Änderung, führte die Tests aus, eröffnete den Pull Request und bat einen Kollegen um ein Review. Alles, was wir automatisiert haben, setzte erst ein, nachdem diese Person fertig war. Eine Software Factory automatisiert die Arbeit selbst, nicht nur das, was danach kommt.
Eine Software Factory verändert die Einheit der Produktion. Arbeit gelangt als Signal in das System, Agents führen sie durch Planung, Implementierung, Verifikation und Release, und Menschen greifen nur dort ein, wo ihr Urteilsvermögen gefragt ist. Mit anderen Worten: Die Softwareproduktion hört nicht auf, wenn sich das Büro leert.
Der Begriff wird allerdings recht unscharf verwendet. Versuchen wir daher, ihn präzise zu fassen, und zwar mit Fokus auf den Teil, der alles verändert: Software wird heute kontinuierlich von Agents produziert, und die Menschen an dieser Linie haben nun eine andere Aufgabe.
Die Definition einer Software Factory
Eine Software Factory ist ein kodifiziertes, weitgehend automatisiertes Produktionssystem, das Arbeit durch den gesamten Softwarelebenszyklus führt: von eingehenden Signalen wie Anfragen, Bugs und Alerts über Planung, Implementierung, Verifikation und Release bis hin zum Monitoring. Agents übernehmen den Großteil der Ausführung innerhalb standardisierter Workflows und Quality Gates. Menschen legen die Intention fest und geben an definierten Checkpoints ihre Freigabe. Das System misst seine eigenen Durchläufe und speist die gewonnenen Erkenntnisse wieder in sich selbst zurück.
Die Definition verdient einen genaueren Blick, denn jeder Teilsatz schließt etwas aus:
Kodifiziert bedeutet, dass die Factory als Code und Konfiguration existiert, also als Repositories, Agent-Definitionen, Policies, Skills und Prompts, sodass sie wie jedes andere System versioniert, getestet und verbessert werden kann.
Gesamter Lebenszyklus bedeutet, dass es sich nicht um einen Coding-Assistenten handelt; sie beginnt, bevor der Code existiert, und läuft nach dem Release weiter.
Agents führen aus bedeutet, dass ein Mensch nicht mehr der Standardarbeiter an jeder Station ist.
Menschen geben an Checkpoints frei bedeutet, dass die Factory beaufsichtigt und nicht sich selbst überlassen wird.
Misst sich selbst bedeutet, dass jeder Durchlauf Daten liefert und die Factory dadurch besser wird.
Vom Assistenten zum Produktionssystem
Meiner Ansicht nach hilft es zu sehen, wie wir hierhergekommen sind. Die erste Welle von KI in der Softwareentwicklung war die Autovervollständigung: Der Engineer tippte, das Modell machte Vorschläge, und der Engineer behielt die Kontrolle über jede einzelne Zeile. Die zweite Welle war der interaktive Agent: Der Engineer beschreibt eine Aufgabe, ein Agent sammelt Kontext, bearbeitet Dateien, führt Tests aus und meldet sich zurück, und der Engineer steuert ihn über das Terminal oder den Editor. Nahezu jedes Entwicklungsteam befindet sich heute in dieser zweiten Welle.
Die Factory ist die dritte Welle, und sie ist etwas grundlegend anderes.
Der Agent wartet nicht mehr darauf, dass ein Engineer tippt. Arbeit gelangt von dort ins System, wo sie entsteht, ein Agent nimmt sie auf, und das System führt sie bis in die Produktion, wobei Menschen nur dort beteiligt sind, wo ihr Urteilsvermögen gebraucht wird. Tereza Tížková von Factory zieht die Grenze klar: Eine Software Factory ist kein Coding-Agent und nicht einmal ein Schwarm von Coding-Agents, denn Code zu schreiben war schon immer der einfache Teil. Die Factory existiert für alles rund um den Code.
Der Loop
Jede funktionierende Factory hat dieselbe Form, und diese Form ist eher ein Loop als eine Pipeline. Deshalb wurde der Begriff „Loop Engineering“ kurzzeitig gehypt, bis man erkannte, dass er dasselbe beschreibt.

Dieser Zyklus wiederholt sich wie ein Uhrwerk:
Arbeit gelangt als Signal herein: eine Feature-Anfrage in Slack, ein Bug-Report, ein Absturz in einem Observability-Tool, Kundenfeedback, ein fehlschlagender Test.
Das Triage entscheidet, ob das Signal echt ist, ob es bereits im Backlog existiert und ob es klein genug ist, um direkt umgesetzt zu werden, oder zuerst eine Spezifikation benötigt.
Die Planung überführt es in klar umrissene Arbeit mit Akzeptanzkriterien, einem Verantwortlichen und einer Zielumgebung.
Implementierungs-Agents schreiben die Änderung, in der Regel in isolierten Umgebungen, sodass mehrere parallel arbeiten können.
Die Verifikation führt Tests und statische Prüfungen aus und zunehmend auch einen Agent, der das Produkt wie ein Kunde verwendet und aufzeichnet, was er sieht.
Das Review kombiniert einen automatisierten Reviewer mit einem Menschen, dessen Beteiligung vom Risiko der Änderung abhängt.
Das Release liefert sie aus.
Das Monitoring beobachtet, was ausgeliefert wurde, und macht aus Anomalien, Incidents und Nutzungsdaten die nächsten Signale.
Wichtig ist, dass die Eingaben standardisiert sind: Jede Arbeitseinheit enthält Umfang, Akzeptanzkriterien, einen Verantwortlichen und eine Zielumgebung. Zusätzlich muss das Tooling standardisiert sein: Von Agents und von Menschen geschriebene Änderungen durchlaufen dasselbe Gateway, dieselben Evaluationen und dieselben Release-Kontrollen. Eine CI/CD-Pipeline automatisiert, was geschieht, nachdem ein Mensch den Code geschrieben hat. Eine Factory standardisiert die Arbeit selbst. Es ist gewissermaßen dasselbe, nur auf zwei unterschiedliche Entitäten angewendet.
Wie Agents innerhalb der Factory arbeiten
Innerhalb einer einzelnen „Einheit“ beschreiben Praktiker eine Struktur, die einem kleinen Team ähnelt.
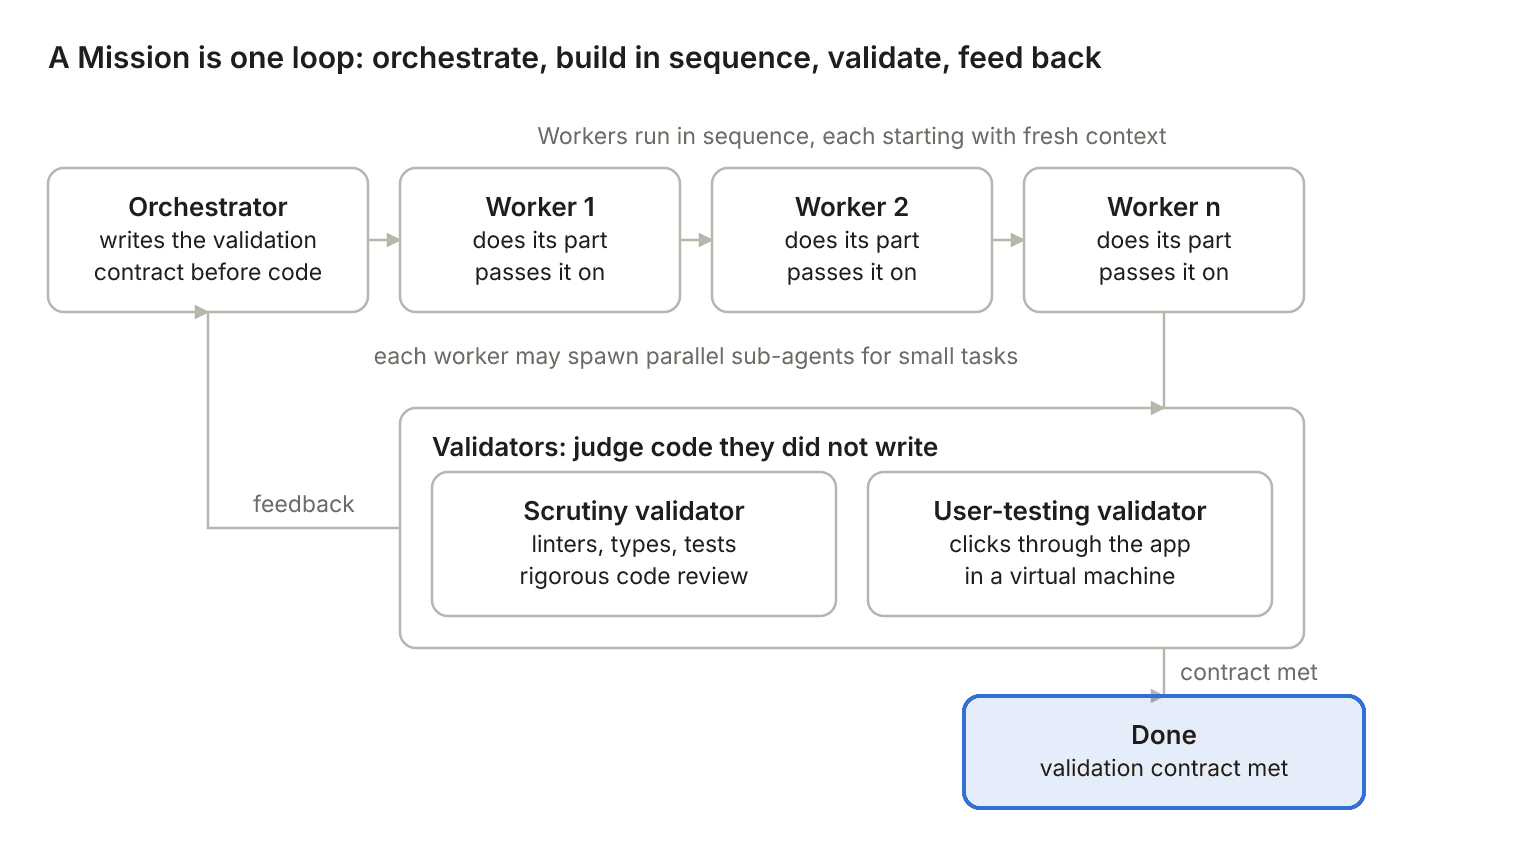
Ein Orchestrator-Agent liest die Aufgabe und hält schriftlich fest, was „fertig“ bedeuten wird, noch bevor Code existiert. Dies wird oft als Validation Contract bezeichnet. Anschließend führen Worker-Agents die Arbeit aus, und hier sind sich Praktiker in etwas Kontraintuitivem einig: Sie arbeiten nacheinander, nicht als Schwarm. Jeder Worker erledigt seinen Teil mit frischem Kontext und übergibt das Ergebnis an den nächsten, so wie ein Kollege einen Pull Request mit klarem Kopf übernimmt. Innerhalb seines eigenen Schritts kann ein Worker parallele Sub-Agents für kleine Aufgaben wie Recherche oder Dateigenerierung starten, aber die Hauptlinie ist sequenziell. Danach beurteilen Validatoren Code, den sie nicht geschrieben haben. Eine Art liest die Codebasis mit der Strenge eines gestrengen Reviewers: Linter, Typen, Tests, Modulgrenzen, duplizierte Logik. Die andere Art sieht sich den Code gar nicht an; sie öffnet das Produkt in einer virtuellen Maschine, klickt sich hindurch und prüft, ob es tatsächlich funktioniert. Wird der Contract nicht erfüllt, geht die Arbeit zurück an den Anfang.
Factory nennt diese langlaufenden Einheiten Missions. Missions laufen bereits über Wochen, und die Unternehmen, die sie entwickeln, erwarten Durchläufe, die Monate dauern.
Was „rund um die Uhr“ tatsächlich bedeutet
Das ist der Teil, den Kunden unterschätzen. Die Factory kennt keine Schichten. Signale treffen zu jeder Stunde ein, Agents nehmen sie zu jeder Stunde auf, und das Einzige, was verhindert, dass eine Arbeitseinheit über Nacht in die Produktion gelangt, ist ein Checkpoint, an dem ein Mensch hinschauen muss.
Warp, das seine eigene Factory öffentlich betreibt, berichtet, dass ein Agent vom Kickoff bis zum Pull Request etwa fünfunddreißig Minuten benötigt und dass der Pull Request anschließend etwa dreieinhalb Stunden auf das erste menschliche Review wartet. Die Factory hat in einem Monat mehr als zweitausend Pull Requests produziert. Doch der Stau entstand bei den Menschen.
Deshalb müssen wir die Rolle des Menschen neu gestalten. Menschen definieren die Intention. Menschen geben Releases frei. Menschen prüfen, was wichtig ist, und was wichtig ist, wird nach Risiko entschieden: Eine Änderung mit kleinem Blast Radius, etwa eine Front-end-Anpassung, die keine gemeinsame Komponente berührt, wird von der Factory gemergt, während eine Änderung an einem Datenbankschema, einer Sicherheitsgrenze oder einer gemeinsam genutzten Bibliothek auf einen Menschen wartet. Die Person, die den Agent per Prompt beauftragt hat, darf auch dessen Ergebnis prüfen, was früher verboten war. Und weil ein unbeaufsichtigter Agent endlos an einem Problem im Kreis laufen wird, das er nicht lösen kann, muss jede Factory harte Grenzen setzen: eine maximale Anzahl an Turns, ein Ausgabenlimit pro Aufgabe und einen Eskalationspfad zu Menschen.
Was das für den Endkundenmarkt bedeutet
Für ein Unternehmen verändert eine laufende Factory mehr als nur die Geschwindigkeit.
Zuerst verschiebt sich der Durchsatz. Teams, die Factories betreiben, berichten von zehn bis zwanzig Pull Requests pro Entwickler und Tag und von Tausenden pro Monat in einem mittelgroßen Unternehmen. In vielen Fällen bedeutet das, dass der Backlog verschwindet. Nicht, weil es keine Issues gäbe, sondern weil Issues kurzlebig werden und schnell gelöst sind. Ein Bug, der um 03:23 Uhr gemeldet wird, wird fünf Minuten später reproduziert und getestet. Und wenn eine mögliche Lösung vorliegt, wird er behoben, bevor ein Engineer überhaupt wusste, dass es ihn gab.
Wir sehen auch, dass sich der Engpass verlagert, und zwar zu den eigenen Mitarbeitenden des Kunden. Das Review wird zur limitierenden Station, und damit muss die Organisation ausdrücklich entscheiden, welche Änderungen noch einen Menschen benötigen und welche nicht. Das ist eine Governance-Entscheidung, und eine sehr schwierige, da sie getroffen werden muss, bevor die Factory läuft, denn eine ungeprüfte Warteschlange von zweitausend Pull Requests ist keine Factory, sondern reines Chaos.
Was viele ängstigt: Kosten werden zu einer erstklassigen Engineering-Metrik. Bei Personal sind die Kosten in gewisser Weise nicht transparent. Natürlich weiß man am Ende, wie viel man pro Abteilung für Gehälter ausgibt, aber sobald man weiß, was jede einzelne Aufgabe kostet, gewinnt man eine Transparenz, die oft beängstigend ist. Eine Factory, die jede Aufgabe auf dem größten Modell ausführt, verbrennt Budget, ohne die Ergebnisse zu verbessern. Die Unternehmen, die Factories betreiben, leiten jede Aufgabe an das günstigste Modell weiter, von dem erwartet wird, dass es die Qualitätsschwelle erreicht, nutzen Caching konsequent, spielen vergangene Aufgaben mit neuen Modellkonfigurationen erneut ab, bevor sie wechseln, und berichten die Kosten pro Pull Request neben der Lead Time.
Die Organisation verändert ihre Gestalt. Arbeit beginnt in öffentlichen Channels statt auf Laptops, sodass jeder sehen kann, was die Factory tut und warum. Product und Engineering verschwimmen, denn wer ein Feature gut genug beschreiben kann, dass ein Orchestrator seinen Validation Contract schreiben kann, leistet Produktarbeit. Teamgrenzen verschwimmen, weil die Factory Kontext benötigt, der früher in Silos lag.
Und auch die Aufgabe der Engineers verändert sich. Sie schreiben weniger Code und liefern mehr aus. Ihre Arbeit besteht darin, das System zu bauen, zu optimieren und zu beaufsichtigen, das das Produkt baut, was manche Factory Engineering oder Harness Engineering nennen. Digital native Unternehmen stellen genau dafür mehr Engineers ein als je zuvor. Kunden, die erwarten, dass eine Factory das Engineering-Team verkleinert, stellen meist fest, dass sie dieselben Leute benötigen, die andere Arbeit leisten.
Eine ehrliche Einschränkung gehört in jedes Kundengespräch. Nahezu alle Spitzenwerte stammen von Anbietern und Unternehmen, die davon profitieren, und die unabhängigen Messungen sind ernüchternd: Die Review-Zeit pro Änderung steigt stark, die Zahl der Pipeline-Läufe steigt, der Durchsatz auf dem Main-Branch sinkt für das mittlere Team. Eine Factory, die nicht als Ganzes konzipiert ist, produziert mehr Code und liefert weniger davon aus.
Was der Kunde mitbringen muss
Eine Factory läuft nicht in einer unvorbereiteten Organisation.
Die Codebasis muss für eine Maschine lesbar sein. Das bedeutet: Linter und Formatter, die den Hausstil abbilden, dokumentierte und zuverlässige Build- und Testbefehle, Tests, die schnell und vertrauenswürdig genug sind, um als Quality Gate der Factory zu dienen, aktuelle Dokumentation (einschließlich der Agent-Dateien, die einem Agent erklären, wie das Repository funktioniert), Modulgrenzen, die klar genug sind, um den Blast Radius einer Änderung zu begrenzen, eine Observability, die gut genug ist, um zu beantworten, warum etwas kaputtgegangen ist, und Security-Scanning, das innerhalb des Loops statt danach läuft. Factory betrachtet diese Punkte als Säulen und betont, dass es menschlichen Engineers genauso hilft wie Agents, sie auszubauen. Stanford hat festgestellt, dass Agents eine unstrukturierte Codebasis verschlimmern und das Chaos schneller wächst, als ein menschliches Team es aufräumen kann.
Umgebungen müssen reproduzierbar sein, auf Abruf und durch eine Maschine. Ein Agent, der eine Änderung validieren will, benötigt eine Sandbox mit den richtigen Daten, Services und Credentials, und zwar innerhalb von Minuten, nicht über ein Ticket. Die Entwicklungsumgebung ist die am meisten unterschätzte Schicht, und die Organisation muss sie selbst verantworten.
Kontext muss vereinheitlicht werden. Unternehmen betreiben Hunderte von Tools, und ein Agent, der sie einzeln entdecken muss, verschwendet Tokens und wählt die falschen aus. Ein MCP-Gateway kann als zentrale Anlaufstelle für alle internen Systeme helfen, mit Beschreibungen dazu, wie das Unternehmen seine Informationen organisiert. Es ist die beste erste Investition für alle, die eine Factory aufbauen.
Vertrauen muss schrittweise aufgebaut werden. Es empfiehlt sich, mit etwas Eng-Umrissenem und Überprüfbarem zu beginnen, etwa dem Incident-Triage, bei dem ein Agent einen Alert liest und eine Diagnose vorschlägt, die ein Mensch bestätigt, und korrekte Diagnosen sich ansammeln zu lassen, bevor die nächste Säule automatisiert wird. Niemand, der eine Factory betreibt, hat sie auf einmal komplett eingeschaltet.
Und schließlich muss jemand sie verantworten. Eine Factory ist ein Produkt mit Kunden, einem Backlog und einem Service Level. Wenn es niemandes Aufgabe ist, sie zu verbessern, bleibt sie auf der Qualität stehen, die sie am Tag ihrer Erstellung hatte.
Wie geht es weiter?
Eine Software Factory allein genügt nicht. Man benötigt die richtigen Umgebungen, die passende Infrastruktur, Kompetenzen und mehr.
Doch das werden wir in den kommenden Wochen behandeln.
Teilen