
Alle Artikel
requestState mit OpenBao absichern
Ein Follow-up zu unserem Artikel im AAIF-Blog „Designing RequestState for Multi-Round Trip Requests“. Der gesamte Code in diesem Beitrag stammt aus dem Begleit-Repository `openbao-mcp-requeststate` und läuft gegen ein echtes OpenBao und das offizielle MCP Python SDK.
·
Max Körbächer
Hinweis: Dieser Beitrag wurde aus dem Englischen übersetzt. Fachbegriffe, Code und Befehle wurden bewusst im Original belassen.
Die häufigste Frage nach unserem Artikel im AAIF-Blog war eine Variante von: „Schön, folgenreicher requestState braucht Integritätsschutz, mit Binding, Ablaufzeit und Replay-Kontrollen wo angebracht – aber womit?" Die MCP-Spezifikation 2026-07-28 sagt wenig über Infrastruktur. Sie schreibt vor, dass ein Server `requestState` als angreiferkontrollierte Eingabe behandeln MUSS und dessen Integrität schützen MUSS, sobald er Autorisierung, Ressourcenzugriff oder Geschäftslogik beeinflusst. Sie sagt nicht, wo die Schlüssel liegen, wie sich zwölf zustandslose Replikas auf sie einigen oder was „diese Bestätigung darf höchstens einmal verwendet werden" durchsetzt.
Dieser Beitrag beantwortet diese Frage mit OpenBao. OpenBao ist ein quelloffener, Community-getriebener Secrets-Manager. Nicht weil ein Secrets-Manager die einzige Antwort wäre, sondern weil jede der drei Lücken, die das SDK offenlässt, auf ein OpenBao-Feature abbildet.
Wo das SDK die Diskussion bereits beendet
Bevor Infrastruktur dazukommt, möchte ich klarstellen, was das SDK bereits mitbringt. Das hier beschriebene Verhalten ist das des im Repository gepinnten offiziellen Python SDK, `mcp==2.0.0`. Auf dem MCPServer ist der requestState-Schutz standardmäßig aktiv. Der Handler schreibt Klartext nach ctx.request_state und liest Klartext zurück; das SDK versiegelt das Token auf dem Weg nach draußen und verifiziert es auf dem Weg herein, sodass über die Leitung immer nur ein opaker, verschlüsselter, authentifizierter Blob geht.
Die Versiegelung leistet mehr als Integrität: Jedes Token ist an ein Zeitfenster gebunden (standardmäßig 600 Sekunden, in jeder Runde neu gestempelt), an den ursprünglichen Request (Methode, Tool- oder Prompt-Name und ein Digest der Argumente) und – wenn der Request ein vom SDK validiertes OAuth-Token trägt – an den authentifizierten Principal. Jeder eingehende requestState auf den drei MRTR-Trägern (tools/call, prompts/get, resources/read) wird geprüft, bevor der Handler läuft, auch wenn er bei einem Handler ankommt, der nie State erzeugt. Manipuliert, abgelaufen, gegen ein anderes Tool wiederholt, von einem anderen Benutzer übernommen oder unter einem Schlüssel versiegelt, den diese Instanz nicht besitzt: Alles bekommt dasselbe eingefrorene -32602 „Invalid or expired requestState". Eine Meldung für jede Ursache, sodass die Leitung nie verrät, welche Prüfung fehlgeschlagen ist. Der wahre Grund landet im Log.
Ein Vorbehalt – und er ist der Grund, warum der Rest dieses Beitrags existiert: Dieser Standardschlüssel wird beim Prozessstart erzeugt und stirbt mit dem Prozess. Ein einzelner stdio-Server: kein Problem. Zwei Replikas hinter einem Load Balancer oder ein Rolling Restart, und jeder laufende Retry bekommt dasselbe -32602.
Die Claims des Envelopes decken den Großteil der Checkliste aus meinem letzten Beitrag ab:
Claim | Erzwingt |
`iat` / `exp` | Ablauffenster (Standard-TTL 600 s) |
`m`, `t`, `a` | Bindung an Methode, Tool/Ressource und einen Digest der relevanten Argumente |
`aud` | Audience – State, den ein anderer Dienst mit denselben Schlüsseln erzeugt hat, wird abgelehnt |
`p` | der authentifizierte Principal, wenn der Server mit OAuth läuft |
Das Tool sieht nie ein Token, nur den Klartext, den es selbst erzeugt hat. Die interessante Frage ist, was der Envelope nicht kann – und alle drei Antworten sind operativer, nicht kryptografischer Natur.
Er kann seinen eigenen Schlüssel nicht verteilen. Die Standard-Policy des SDK ist RequestStateSecurity.ephemeral(): ein zufälliger Schlüssel, erzeugt beim Prozessstart. Man erinnere sich, warum es MRTR überhaupt gibt: Es lagert den Wiederaufnahme-State aus, damit zustandslose, horizontal skalierte Server interaktive Abläufe ohne Sticky Routing ausführen können. Mit einem ephemeren Schlüssel kann dieses Versprechen brechen: Der Load Balancer schickt Runde 2 an Replika B, Replika B hat einen anderen Schlüssel, und ein völlig ehrlicher Client bekommt Invalid or expired requestState. Ein Neustart mitten in der Konversation macht dasselbe mit jeder laufenden Runde. Der Docstring des SDK sagt es unmissverständlich: Multi-Instanz-Deployments müssen Schlüssel teilen. Schlüssel zu teilen ist ein Secrets-Management-Problem.
Er kann keine Key-Custody-Vorgabe erfüllen. Der eingebaute Codec hält AES-Schlüsselmaterial im Anwendungsspeicher. Viele Umgebungen sind damit einverstanden; manche dürfen es nicht sein.
Er kann nichts einmalig machen. Das ist der subtile Punkt, klar in den Specs formuliert: Principal-Bindung, TTL und Request-Bindung begrenzen das Replay-Fenster, ABER sie „garantieren für sich genommen keine Einmalverwendung". Wo ein requestState höchstens einmal konsumiert werden darf – einmalige Einlösungen sind der kanonische Fall –, MUSS der Server diese Invariante serverseitig durchsetzen. Eine versiegelte, gebundene, nicht abgelaufene Bestätigung zum Löschen von Dateien ist auch beim zweiten Vorzeigen eine gültige Bestätigung zum Löschen von Dateien. At-most-once ist am Ende ein State-Problem, und keine Kryptografie auf einem zustandslosen Token löst es.
Das Beispiel: ein destruktives Tool, zwei Round Trips
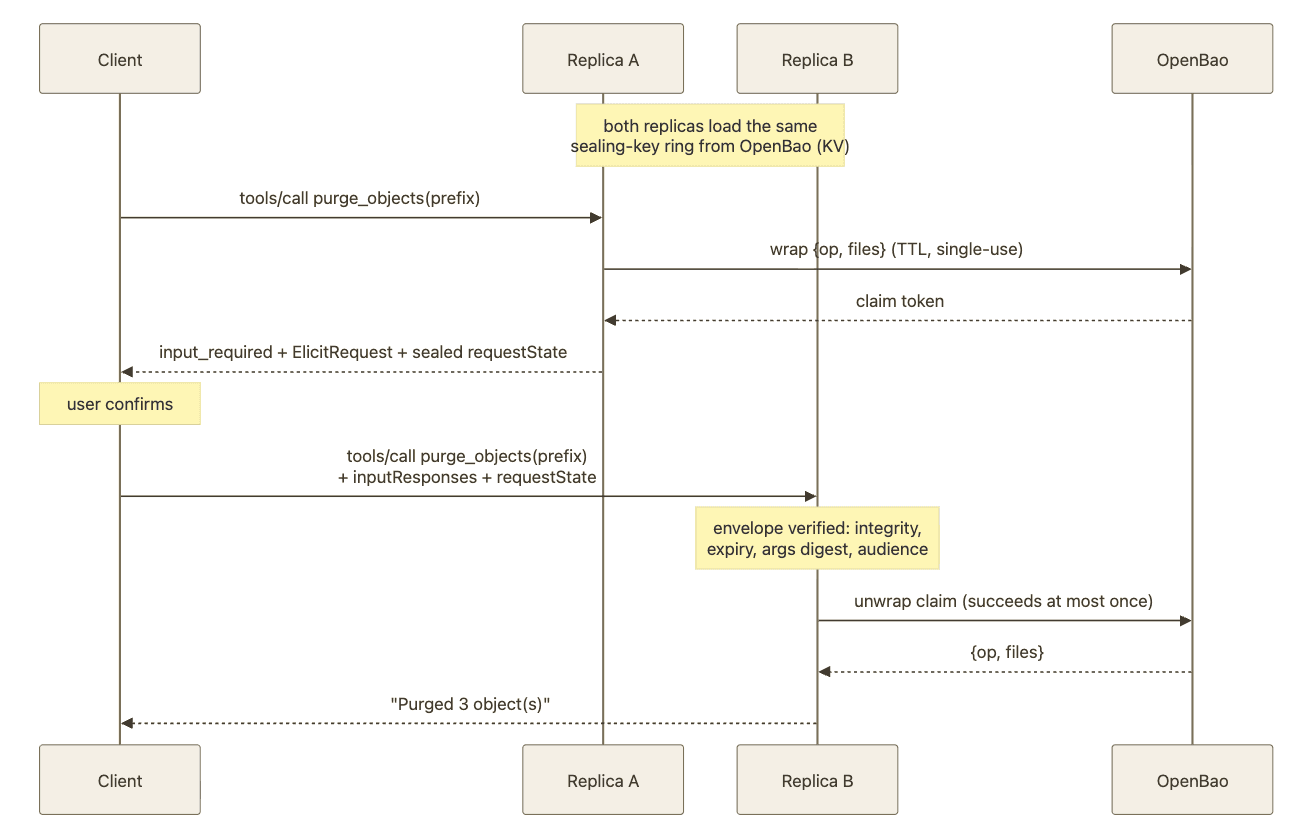
Das Repo betreibt storage-janitor, einen MCP-Server mit einem einzigen Tool. purge_objects(prefix) durchsucht einen Bucket, kommt mit einer Elicitation wie „Purge 3 object(s) under 'logs/'?" zurück und schließt beim Retry ab:
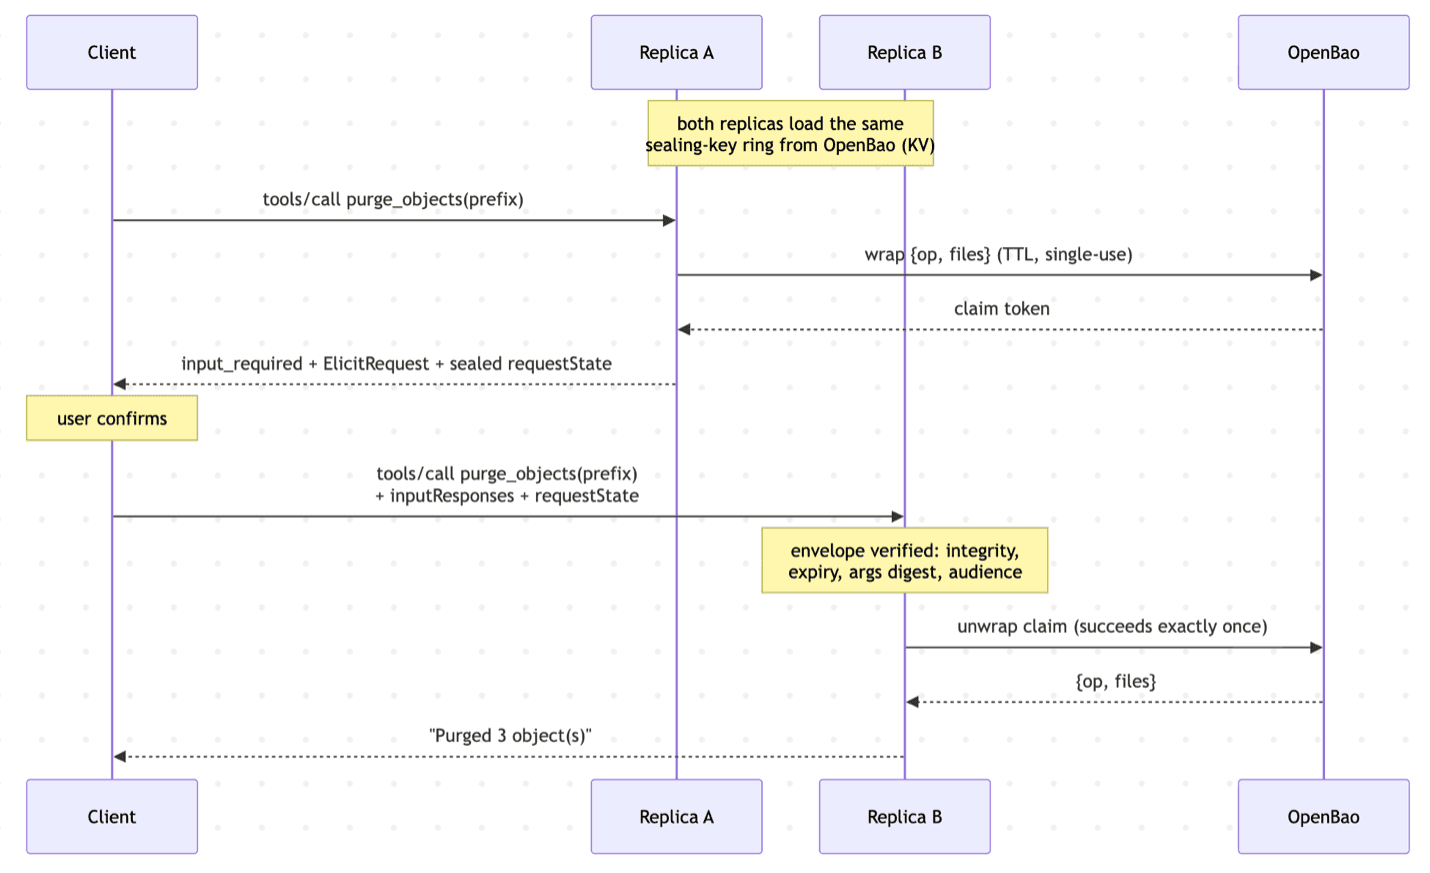
In Runde 1 kehrt der Server früh zurück, statt zurückzufragen:
Dieser `v1.…`-Blob ist der versiegelte Envelope des SDK. Was das Tool tatsächlich hineingelegt hat, sind zwei Felder: {"step": "confirm", "claim": "s.lfT6gNneH4…"}; und dieses zweite Feld ist der Punkt, an dem OpenBao ins Spiel kommt.
Daraus ergeben sich drei Integrationen, in aufsteigender Reihenfolge ihrer Eingriffstiefe.
1. Ein gemeinsamer Startup-Schlüsselring, verteilt über OpenBao
Die Standard-Integration behält das lokale AES-GCM-Sealing des SDK und verlagert nur das Schlüsselmanagement nach OpenBao. Jede Replika holt beim Start denselben Ring aus KV und übergibt ihn an die Boundary:
Das ist bereits die gesamte Lösung für Lücke 1. Runde 1 kann auf Replika A landen und Runde 2 auf Replika B; die Demo zeigt genau dieses Verhalten, und B schließt einen Purge ab, den es nie geplant hat. Neustarts invalidieren keine laufenden Runden mehr, weil der Schlüssel den Prozess überlebt.
Die Demo etabliert gemeinsame Startup-Schlüssel: Replikas, die mit demselben Ring gestartet wurden, können laufenden State austauschen. Sie implementiert keine Live-Key-Reloads und keine Zero-Downtime-Rotation. In Produktion erfordert Rotation koordinierte Ring-Updates und Replika-Reloads:
Den neuen Schlüssel zuerst zum Entsiegeln verteilen (`keys=[old, new]`) und erst dann mit ihm versiegeln (`keys=[new, old]`), wenn jede Replika neu geladen hat. Andernfalls lehnt eine noch nicht neu geladene Replika State ab, den eine bereits rotierte erzeugt hat. Die Kommandos `setup.sh rotate` und `retire` des Repositories bearbeiten nur KV (und rotieren Transit); sie orchestrieren diese Reloads nicht. Die für den Envelope gewählte TTL bestimmt die minimale Wartezeit vor dem Retirement, nachdem die Aktivierung abgeschlossen ist.
Der Einfachheit halber verwendet die Demo eine einzige AppRole-Policy, die den Ring des lokalen Codecs lesen, Transit nutzen sowie wrappen und unwrappen darf. Das bedeutet: Ein kompromittierter Demo-Server im Transit-Modus könnte auch den Ring des lokalen Codecs abrufen – den Transit-Schlüssel exportieren oder den Ring schreiben kann er trotzdem nicht. Eine produktive Key-Custody-Grenze sollte getrennte AppRoles und Policies verwenden: Key-Ring-Deployments dürfen KV lesen, Transit-Deployments dürfen mit Transit nur ver- und entschlüsseln. Wrapping-Berechtigungen separat dort vergeben, wo sie gebraucht werden.
2. Transit: wenn der Schlüssel im Prozess gar nicht existieren darf
Wenn die Policy vorschreibt, dass AEAD-Schlüssel nie im Anwendungsspeicher liegen, dreht man die Anordnung um: Schlüsselmanagement und Kryptografie bleiben in OpenBao. Das SDK macht daraus einen Zehn-Zeilen-Codec, denn `RequestStateSecurity` akzeptiert jedes Objekt mit `seal`/`unseal`:
Das SDK erzeugt und verifiziert weiterhin jeden Claim; OpenBao führt nur das AEAD aus. Der für den Client sichtbare `requestState` wird zu wörtlichem Transit-Chiffretext `vault:v2:73oTCJZRcrTdFBTK…`, und Rotation reduziert sich auf `transit/keys/<name>/rotate` plus `min_decryption_version`. Ist ein OpenBao-Audit-Device aktiviert, wird jedes Seal und Unseal im Audit-Log festgehalten. Jedes Transit-Seal/Unseal macht einen synchronen Aufruf zu OpenBao und blockiert den Worker, bis dieser Round Trip abgeschlossen ist. Das erscheint mir nützlicher Kontext für alle, die diese Option gegen den gemeinsamen Schlüsselring abwägen.
3. Response Wrapping: at-most-once
Lücke 3 braucht serverseitigen State mit ungewöhnlichen Eigenschaften: kurzlebig, höchstens einmal einlösbar, manipulationssicher und auditierbar, wenn ein Audit-Device aktiviert ist. Und so landen wir wieder bei OpenBao und seinem Response Wrapping. Ein Payload wird gewrappt, und OpenBao speichert ihn serverseitig hinter einem kurzlebigen, einmalig verwendbaren Wrapping-Token. Ein erfolgreiches Unwrap konsumiert dieses Token; weitere Unwraps schlagen fehl.
Das Tool parkt also den destruktiven Plan in OpenBao und legt nur den Claim-Check in den `requestState`:
In meinem AAIF-Blog hatte ich die Wahl zwischen Value und Reference angesprochen: Mit diesem Ansatz verweigert sie sich der Entscheidung. Der Wiederaufnahme-Kontext reist by value im versiegelten Envelope; der gefährliche Teil, die maßgebliche Liste dessen, was gelöscht wird, reist by reference und überquert die Vertrauensgrenze überhaupt nicht. Der Client trägt eine Capability, die er nicht lesen kann (der Envelope ist verschlüsselt, das Claim-Token taucht also nie in Client-Logs auf), nicht unbemerkt verändern kann und nicht zweimal erfolgreich einlösen kann. Lehnt der Benutzer ab, verbrennt das Tool das Token sofort, statt es altern zu lassen.
Das ist At-most-once-Einlösung der Autorisierung, nicht atomare oder Exactly-once-Ausführung des Purge. Unwrap und Löschung sind getrennte Operationen: Fällt der Server nach dem Unwrap, aber vor oder während der Löschung aus, wird ein Retry abgelehnt, obwohl die Löschung unvollständig sein kann. Stärkere Ausführungsgarantien erfordern eine idempotente Löschoperation, ein persistentes Operations-Ledger oder eine transaktionale Kopplung von Einlösung und Ausführung.
Wie die Angriffe aussehen
`run_demo.sh` startet OpenBao-konfigurierte Replikas und fährt vier Züge gegen einen legitim ausgestellten `requestState`:
Jede Zeile ist eine andere Schicht, die ihre Arbeit macht:
Das manipulierte Token stirbt im Codec (GCM-Tag)
das umgelenkte stirbt im Claims-Check (Argument-Digest; eine Bestätigung für `logs/` ist keine Bestätigung für `secrets/`)
das Replay überlebt beides, weil es ein tatsächlich gültiges Token ist, und stirbt an der einzigen Schicht, die es töten kann: der Single-Use-Einlösung in OpenBao.
Das SDK loggt den echten Ablehnungsgrund der Boundary serverseitig, während die Leitung nur die eingefrorene Meldung sieht. Ist ein OpenBao-Audit-Device aktiviert, hinterlässt ein fehlgeschlagenes Unwrap zudem einen Audit-Eintrag, auf den sich ein Alert lohnt. Dieser Fehler allein unterscheidet nicht zwischen einem wiederholten, einem abgelaufenen, einem widerrufenen oder einem unbekannten Token – die Diagnose braucht den umgebenden Audit-Kontext.
Anmerkungen für die Produktion
Die Demo betreibt OpenBao im Dev-Modus; die Distanz zur Produktion ist die übliche Checkliste: TLS auf `BAO_ADDR`, persistenter Storage und Auto-Unseal, ein aktiviertes Audit-Device und echte Secret-ID-Zustellung für AppRole. Zwei Stellschrauben verdienen echtes Nachdenken. Die Envelope-TTL ist eine UX-Entscheidung im Gewand einer Sicherheitsentscheidung; sie muss die ehrliche Bedenkzeit des Benutzers bei der Elicitation abdecken, und 600 Sekunden Standard-Großzügigkeit können mehr Wiederaufnahme-Fähigkeit sein, als ein destruktives Tool haben will; die Demo fährt beide TTLs mit 120 s. Und wenn der Server OAuth terminiert, bindet das SDK jeden Envelope ohne eine zusätzliche Zeile Code an den authentifizierten Principal, sodass das Cross-User-Replay in der Boundary stirbt, bevor das Tool läuft.
Das Muster selbst ist klein: den Envelope des SDK behalten; ihm Schlüssel aus einem System geben, dessen Job Schlüssel sind; und Autorisierung, die höchstens einmal eingelöst werden darf, hinter ein serverseitiges Einlösungs-Primitiv legen. Diese Einlösung mit idempotenter oder dauerhaft nachverfolgter Ausführung koppeln, wenn die Operation selbst eine stärkere Garantie braucht. Wenn der Besitz von requestState ausreicht, um eine privilegierte Operation wiederaufzunehmen, funktioniert er als Bearer-Capability in der Hand einer nicht vertrauenswürdigen Partei.
Man behandle ihn mit Token-Disziplin – und gebe dieser Disziplin Infrastruktur.
Teilen